
费城半导体一夜暴跌近6%,AI“减速”吓崩了谁哪些大跌,哪些抗揍
2026-09-15 · helvyuanshop.com
费城半导体一夜暴跌近6%,AI“减速”吓崩了谁哪些大跌,哪些抗揍 隔夜美股科技大跌,费城 半导体 指数暴跌近6%,成分股全线下跌,存储几大巨头也集体走弱。 为啥突然崩了重要导火索——好几家美国顶尖AI公司的CEO公开喊话,说要放缓技术发展。 分三个层次看:第一种是模型发布节奏放慢,第二种是训练规模不再猛扩,第三种是直接砍 数据中心 的资本开支。 这三种“刹车
费城半导体一夜暴跌近6%,AI“减速”吓崩了谁哪些大跌,哪些抗揍
隔夜美股科技大跌,费城 半导体 指数暴跌近6%,成分股全线下跌,存储几大巨头也集体走弱。
为啥突然崩了重要导火索——好几家美国顶尖AI公司的CEO公开喊话,说要放缓技术发展。
分三个层次看:第一种是模型发布节奏放慢,第二种是训练规模不再猛扩,第三种是直接砍 数据中心 的资本开支。
这三种“刹车”踩下去,对AI硬件的影响完全不是一个量级。轻的只是商业化慢一点,重的直接动摇GPU、HBM的 算力 需求,最狠的那种,整条产业链的订单和盈利预期都得跟着抖三抖。
AI巨头到底在哪一层踩刹车,才是判断AI硬件接下来怎么走的关键。
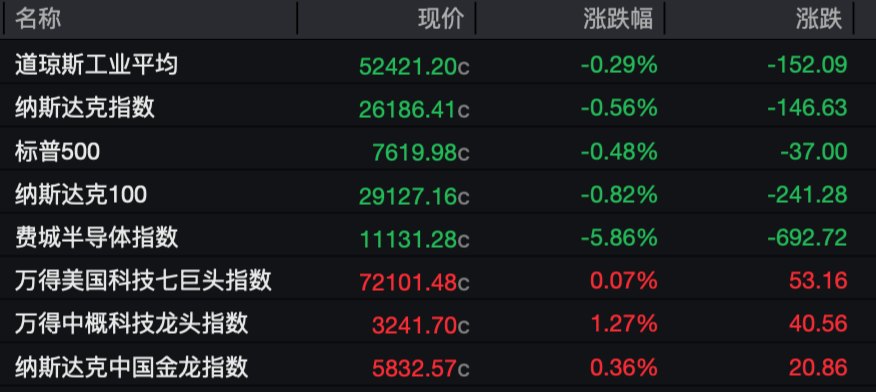
北京时间9月15日凌晨,美股三大指数收跌。道琼斯工业平均指数跌152.09点,收报52421.20点,跌0.29%;纳斯达克指数跌146.63点,收报26186.41点,跌0.56%;标普500指数跌37点,收报7619.98点,跌0.48%。
多家美国顶尖 AI 企业 CEO 呼吁放缓技术发展,受此消息冲击,AI 硬件产业链板块股价显著回调。
费城半导体指数重挫5.86%,成分股全线收跌。泰瑞达跌13.30%,COHERENT跌12.73%,ASTERA L ABS 跌11.74%,思佳讯跌10.29%,ARM跌9.74%,英特格、拉姆研究跌超8%,蓝博士半导体、迈威尔科技、格芯、阿斯麦、应用材料跌超7%,安森美半导体、英特尔跌超5%。
存储板块整体疲态尽显。SK海力士跌7.60%,美光科技跌5.25%,闪迪跌4.98%,西部数据跌4.53%,希捷科技跌2.97%。
万得美国科技七巨头指数涨0.07%。谷歌涨3.06%,脸书涨2.71%,微软涨1.97%,苹果涨0.24%;亚马逊跌1.26%,特斯拉跌1.77%,英伟达跌3.36%。
第一种:模型发布节奏放慢——更多影响商业化,未必影响算力
假设一家AI公司原本计划10月发布下一代模型,现在因为需要增加安全测试、第三方评估和对齐工作,推迟到12月甚至明年才正式面向公众开放。
这种情况下,模型发布慢了,但模型未必少训练。事实上,Amodei此次提出的「pacing the frontier」也特别做了区分。他明确表示,「放慢」并不是停止模型训练或技术进步,而是希望在模型能力提升的同时,留出更多时间进行安全、对齐及第三方评估。
假如模型已经完成大部分训练,只是延长评测周期,那么此前消耗的GPU算力并不会因此「退货」。更重要的是,安全评估本身同样需要算力。模型需要做更长时间的红队测试、Agent模拟、强化学习、可解释性研究以及大量推理测试。Amodei甚至提到,未来第三方评估者可能不只评估最终模型,也会直接检查训练和模型开发流程。
换句话说:模型晚发布 ≠ GPU少使用。
真正首先受到影响的,反而可能是AI商业化的时间表。如果下一代模型推迟几个月推出,那么依赖新模型能力的API收入、Agent产品、企业 AI应用 以及订阅收入,可能同步后移。
因此第一种「放缓」对产业链更像是:软件收入确认延后,但硬件需求未必同步下降。对英伟达、AMD、HBM、 光模块 等AI硬件股而言,短期可能带来估值和情绪波动,但还很难直接推导出盈利预期下修。
第二种:训练扩张放慢——这才开始真正碰到AI硬件需求
如果「安全放缓」进一步演变成:下一代模型不再快速扩大训练规模,或者超大模型训练频率下降,那么AI硬件需求才会真正受到影响。
过去两年,AI硬件最核心的投资逻辑,就是下一代模型需要更多算力。从几万张GPU到十万、数十万甚至百万卡集群,训练规模不断扩张,带动GPU、HBM、先进封装、 交换机 和光模块需求爆发。
但「训练放慢」也不能简单等同于算力需求下降,真正需要看的是:单次训练规模有没有下降、训练频率有没有降低,以及全年总算力投入是否减少。
例如,一家公司原本每年训练4次大型模型、每次使用10万张GPU,现在改成一年2次;但如果单次训练规模提升至20万张GPU,再叠加后训练、安全评估、智能体测试等需求,全年实际消耗的算力未必下降。
因此,硬件投资者真正需要关注的,不是「大模型多久发布一次」,而是一年到底用了多少算力。
如果训练算力真的下降,GPU和HBM将首当其冲,高速网络也会受到影响。因为AI集群越大,对交换芯片、800G/1.6T光模块、CPO等高速互连的需求越高。一旦百万卡集群扩张节奏放慢,相关产业链原本较高的增长预期自然需要重新评估。
不过,这并不意味著AI算力需求就此见顶,因为另一股需求正在接棒——推理算力。
随著AI从模型训练走向大规模应用,尤其是智能体逐渐普及,一个任务往往需要多轮推理、搜索、工具调用和结果验证,带来的推理算力需求可能远高于传统聊天 机器人 。
因此,即使前沿模型训练节奏放慢,只要AI使用量继续增长,硬件需求更可能是从训练端向推理端转移,而不是简单减少。未来AI硬件的竞争重点,也可能逐渐从「谁能提供最多训练算力」,转向「谁能以更低成本、更高能效提供更多推理算力」。
第三种:资本开支下降——这才是AI硬件真正需要警惕的信号
相比模型发布和训练节奏,资本开支才是判断AI硬件景气度更直接的指标。
因为GPU、HBM、 服务器 、交换机、光模块、液冷、SSD,以及 变压器 、UPS、燃气轮机等环节,最终都依赖一件事:科技巨头是否还在持续扩建AI数据中心。
只要亚马逊、微软、Meta、谷歌等大型云厂商仍维持高强度投入,AI硬件的订单基础就还在;反过来,如果这些公司开始系统性下调资本开支,才意味著产业链的盈利预期需要重新评估。
目前来看,这个信号还没有出现。相反,大型科技公司的AI投资仍处于高位。
因此,现阶段更准确的理解是:AI公司开始讨论放慢前沿模型的能力提升速度,但基础设施投资本身并没有同步降温。
市场担心的,是模型开发放缓最终会不会进一步传导至训练算力、数据中心需求,最后影响资本开支和硬件订单。
但目前能看到的,主要仍是前沿模型在安全和发布节奏上的调整,距离科技巨头真正削减数据中心预算,还不是同一件事。
所以对AI硬件而言,接下来更值得关注的是大型云厂商的资本开支指引有没有开始下修。
哪些AI硬件更容易受到「放缓」影响
如果把整条AI硬件产业链拆开来看,不同环节对「放缓」的敏感程度其实并不一样。
如果只是模型发布延后,对GPU和HBM的实际需求影响有限。但如果下一代模型开始控制单次训练规模,或者大型模型训练次数明显减少,那么GPU与HBM会是最先受到影响的环节。
因此,对$英伟达 (NVDA.US)$、$美国超微公司 (AMD.US)$、$SK海力士 (SKHY.US)$、$美光科技 (MU.US)$等公司而言,真正重要的不是新模型晚几个月发布,而是下一代AI集群到底还需要多少算力、多少芯片。
光通信对超大规模AI集群尤其敏感。GPU数量越多,芯片与服务器之间交换的数据量越大,对高速网络、交换芯片、光模块和CPO的需求也越强。
因此,如果未来百万卡级AI集群的建设速度下降,光通信此前建立在「集群持续扩大」上的高增长预期就需要重新评估。反过来,如果只是模型发布延后,但数据中心和AI集群仍然照常扩建,对光通信基本面的实际影响也相对有限。
服务器、液冷:更看项目有没有真正落地
服务器和液冷与数据中心实际部署的关系更直接。只要GPU还在交付、机柜还在上架,相关需求就会继续兑现。因此这一环节更需要警惕的,不是哪个模型推迟发布,而是数据中心项目本身出现延期、缩减甚至取消。
变压器、燃气轮机、发电设备等电力基础设施的建设周期更长,不少订单也会提前数年锁定。因此,短期模型开发节奏改变,很难立刻影响已经开工的数据中心和电力项目。即使未来AI资本开支真的降速,电力链受到影响的时间通常也会晚于GPU、服务器等环节。
美股频道更多独家策划、专家专栏,免费查阅>>